
Neues Open-Source-LLM? Wir prüfen es für Ihren Use Case.
Ihr Modell-Monitoring für Open-Source-LLMs
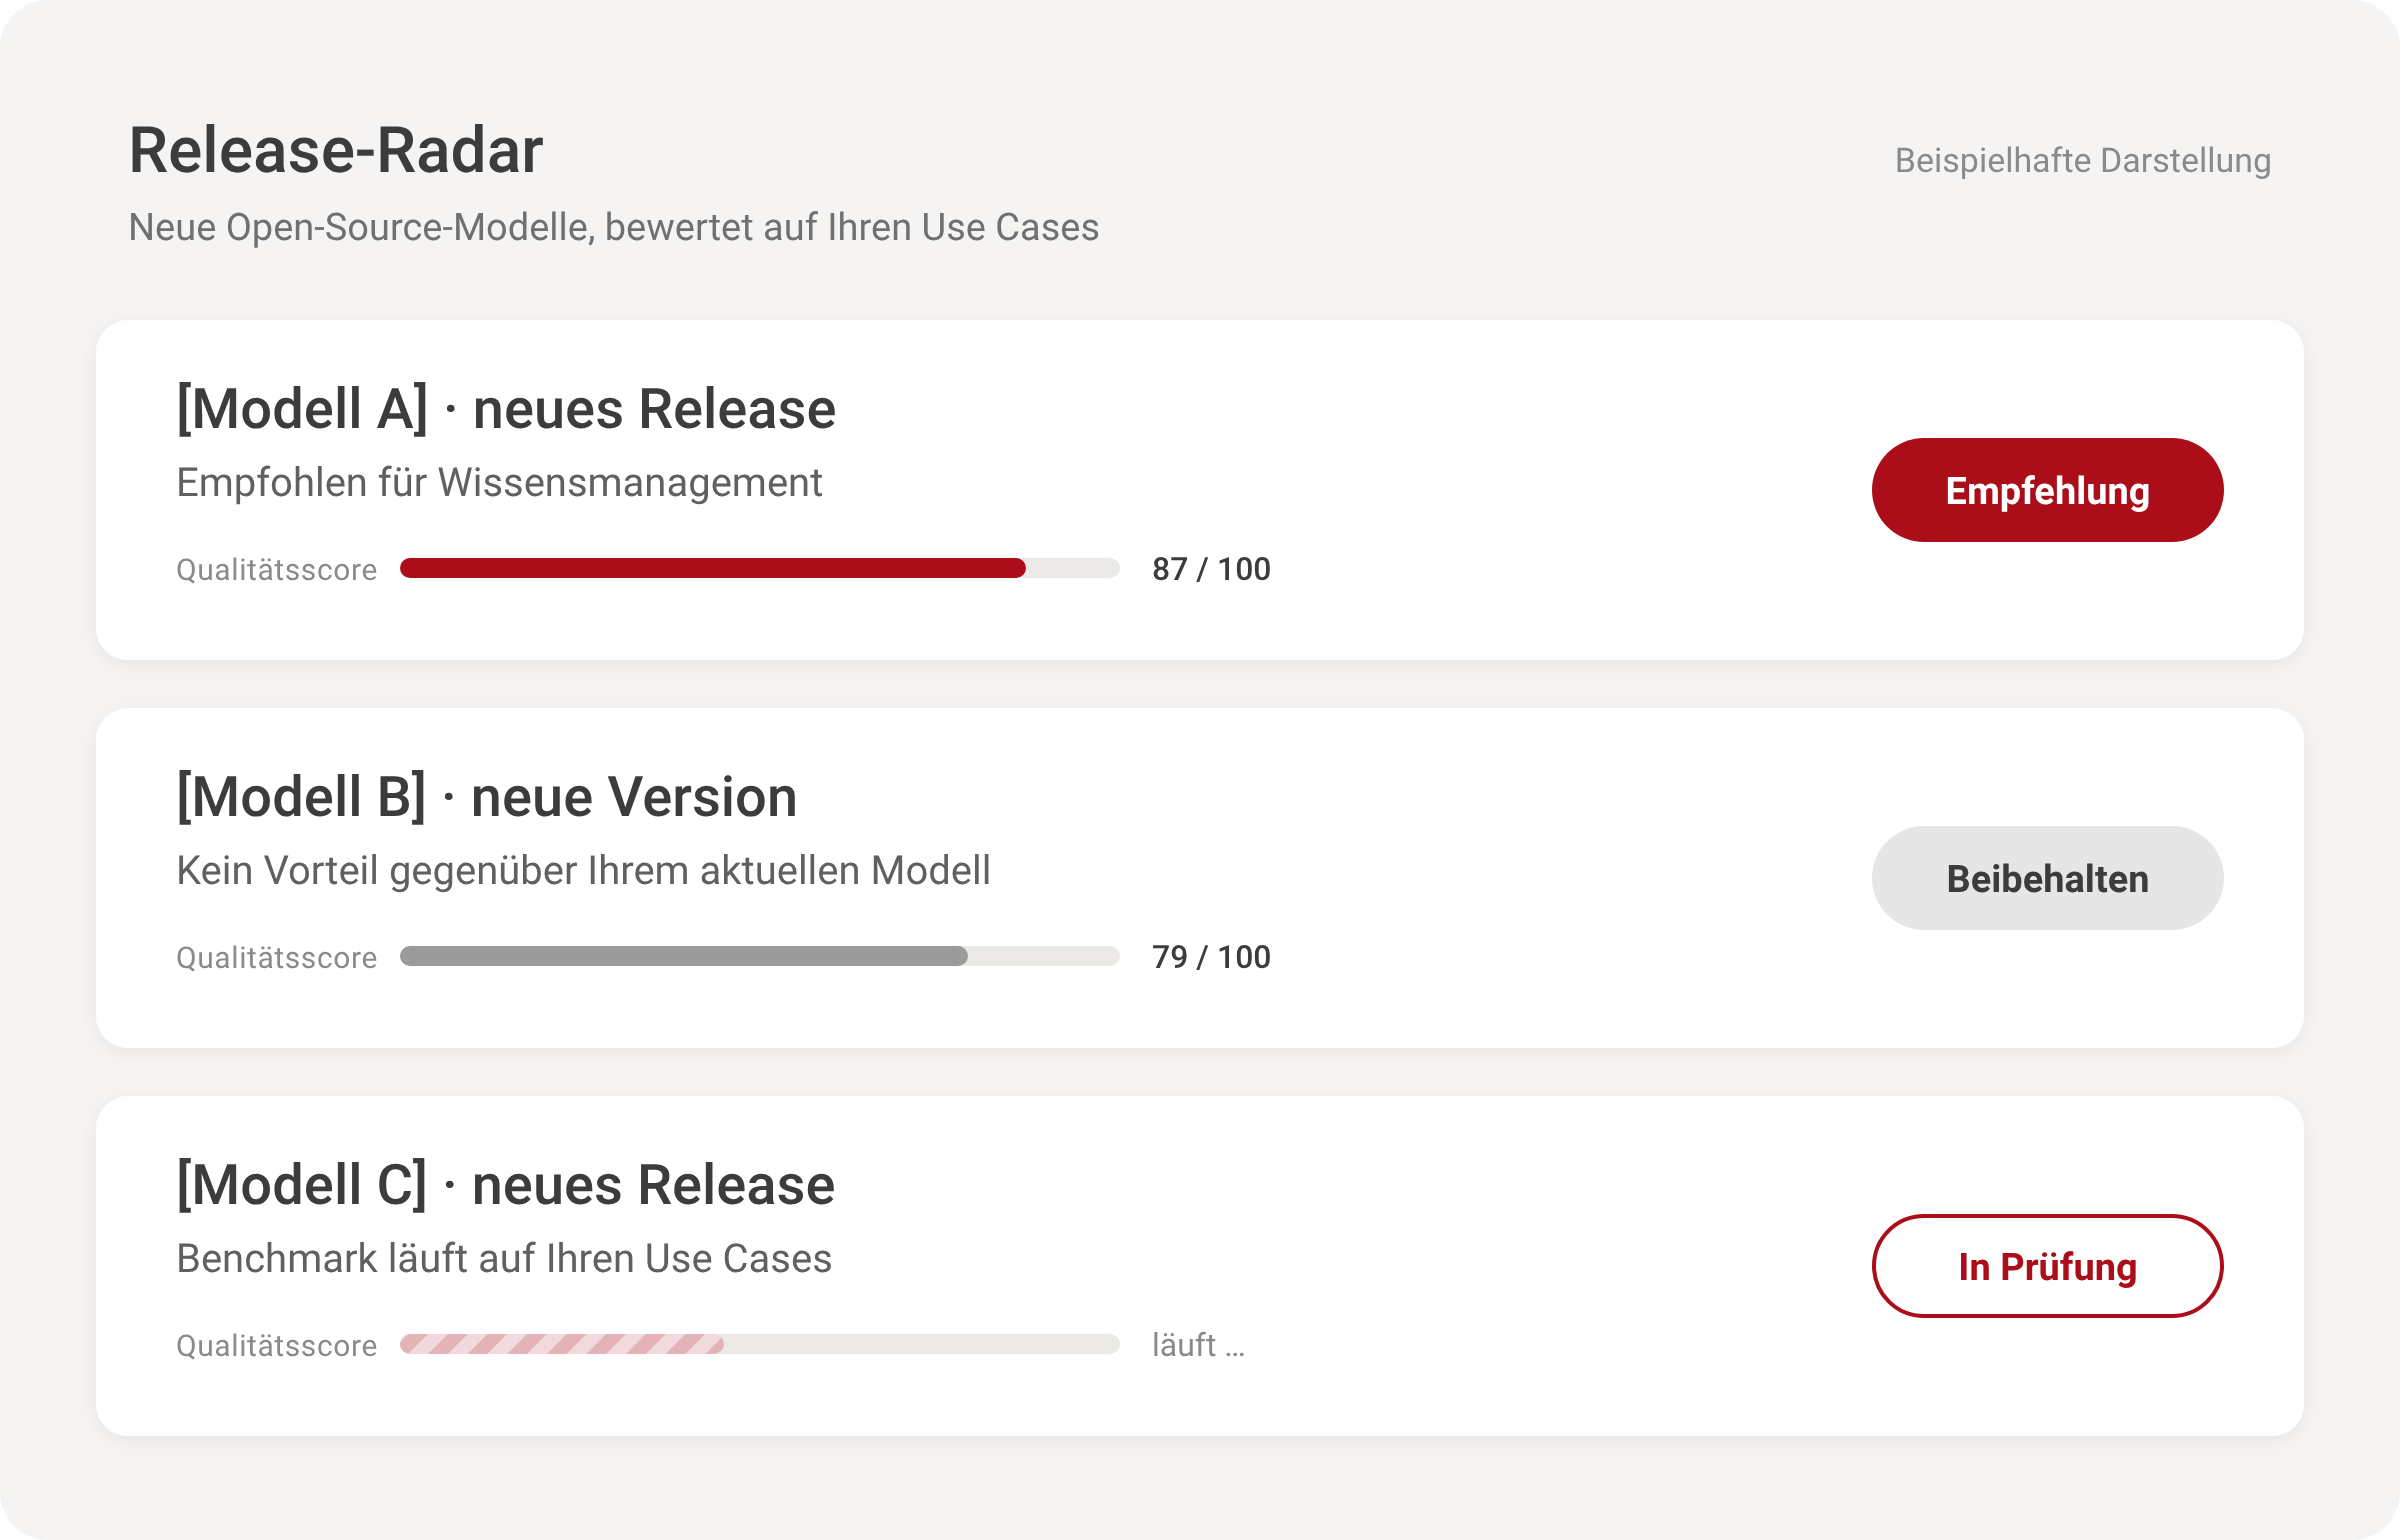
- Jedes relevante Release im Blick: Wir verfolgen den Open-Source-Markt kontinuierlich und bewerten neue Modelle und Modellversionen, sobald sie erscheinen – nach einem festen, nachvollziehbaren Verfahren.
- Empfehlungen für Ihren Use Case: Wir kennen die Anwendungsfälle unserer Kunden. Deshalb sagen wir Ihnen konkret, ob sich ein Wechsel lohnt – für Wissensmanagement vielleicht ein anderes Modell als für die Fachrecherche.
- Sie geben den Rahmen vor: Lokales Open-Source-Modell, Cloud-Modell oder beides: Wir beraten aktiv, richten uns aber vollständig nach Ihren Vorgaben – inklusive eigener Wunschmodelle.
In fünf Schritten vom neuen Release zur fundierten Empfehlung
So funktioniert unser Benchmark:
- Testgrundlage definieren: 500 bis 2.000 pseudonymisierte Dokumente, dazu typische Fachfragen mit bekannten, korrekten Antworten.
- Modelle automatisiert testen: Die Fragen gehen automatisiert an einen KI-Assistenten mit Zugriff auf die Dokumente – jedes Modell unter gleichen Bedingungen.
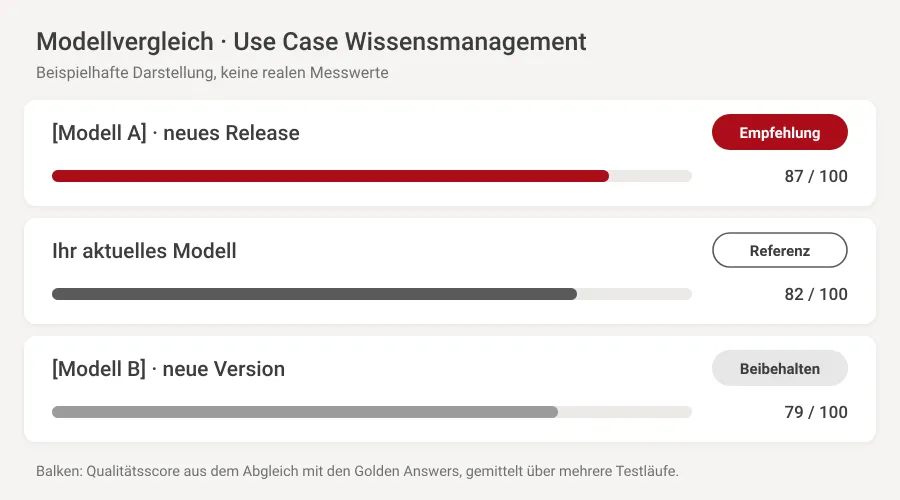
- Antworten bewerten: Der Abgleich mit den Referenzantworten (Golden Answers) ergibt einen Qualitätsscore pro Modell.
- Ergebnisse vergleichen: Mehrfache Testläufe gleichen Schwankungen aus und zeigen, wie zuverlässig ein Modell wirklich antwortet.
- Schwachstellen analysieren: Auffällige Antworten werden KI-gestützt untersucht. So erkennen wir Fehlerbilder und leiten Verbesserungen ab.
Gemessen, nicht geschätzt: Warum öffentliche LLM-Rankings nicht ausreichen
Herstellerangaben und öffentliche Ranglisten sagen wenig darüber, wie gut ein Modell mit Ihren Dokumenten und Ihren Fragen umgeht. Unser Benchmark schon.
Sie erhalten pro Modell einen Qualitätsscore, eine Aussage zur Zuverlässigkeit über mehrere Durchläufe und eine klare Empfehlung – nachvollziehbar dokumentiert und jederzeit wiederholbar.
Was Ihnen LLM-Benchmarking von IntraFind bringt
 Objektiver Modellvergleich: Unterschiedliche LLMs anhand identischer Aufgaben bewerten.
 Praxisnahe Bewertung: Realistische, unternehmensrelevante Fragestellungen statt abstrakter Benchmarks.
 Nachvollziehbare Qualität: Messbare Scores machen Leistungsfähigkeit und Zuverlässigkeit transparent.
 Schnellere Modellauswahl: Neue Modelle und Versionen systematisch auf ihre Eignung prüfen – ohne eigenen Testaufwand.
 Gezielte Optimierung: Schwächen werden sichtbar und lassen sich gezielt untersuchen und beheben.

Wir empfehlen aktiv. Die Entscheidung bleibt bei Ihnen.
Beraten statt vorschreiben
Unsere Plattform ist modellagnostisch. Ob Sie unserer Empfehlung folgen, bei Ihrem bewährten Modell bleiben oder ein eigenes Wunschmodell testen lassen: Wir setzen um, was zu Ihren Anforderungen, Ihrem Betriebsmodell und Ihren Compliance-Vorgaben passt.
- Lokale Open-Source-Modelle, kommerzielle Cloud-Modelle oder eine Kombination
- Benchmarks auf Ihren eigenen Fragestellungen und Dokumenten
- Modellwechsel jederzeit umkehrbar – kein LLM-Vendor-Lock-in
- Persönliche Beratung durch Experten, die Ihre Anwendungsfälle kennen
Wann sich LLM-Benchmarking für Ihr Unternehmen lohnt



Sicher, souverän, regelkonform
✔️EU-KI-Verordnung - Die Enterprise AI Plattform ist konform zur KI-Verordnung (EU) 2024/1689
✔️DSGVO-konform - Datenschutzkonformer Betrieb nach DSGVO
✔️Kein Modelltraining mit Kundendaten - Ihre Daten werden nicht für das Training von KI-Modellen verwendet
✔️Data Residency - Sie bestimmen, wo Ihre Daten verarbeitet und gespeichert werden
✔️Software Made in Germany
Mehr zum Thema: AI Governance & Model Choice · Qualität messen & optimieren · Betriebsmodelle & Souveränität


